Elle yazılan SIMD, derleyiciyi ne zaman geçer?
Aynı dot product döngüsünü dört şekilde derledim. 17 katlık farkın arkasında toplama sırası, birkaç bayrak ve derleyicinin ürettiği kod var.

Çağrı başına medyan süre · PDF Tablo II
4.096 elemanlık bir dot product hesabı, scalar sürümde 5.117 ns sürüyor. Elle yazılmış AVX2 sürümünde süre 300 ns. Yaklaşık 17 katlık bir fark var.
Ben bu karşılaştırmada bir başka sayıyı da önemsiyorum: 321 ns. O sonuç da derleyiciden geliyor. Aynı C++ döngüsünü, toplamaları yeniden gruplamasına izin vererek derleyince elde ediliyor.
Dolayısıyla elle SIMD yazmanın ne kazandırdığını anlamak için önce derleyicinin hangi kurallara uyarak çalıştığına bakmak gerekiyor. Çalışmada bu ayrımı dört sürüm ve iki ayrı hedef komut kümesi üzerinden inceledim. Bu yazıda hesabı, deney düzenini ve sonuçların ne söylediğini adım adım açacağım. Kaynak PDF ve tablo verileri de aşağıda var.
Hesap küçük, toplama sırası önemli
Dot product’ın yaptığı iş basit: iki dizinin karşılıklı elemanlarını çarpıp hepsini toplamak. Dört elemanlık küçük bir örnekte işlem şöyle görünüyor:
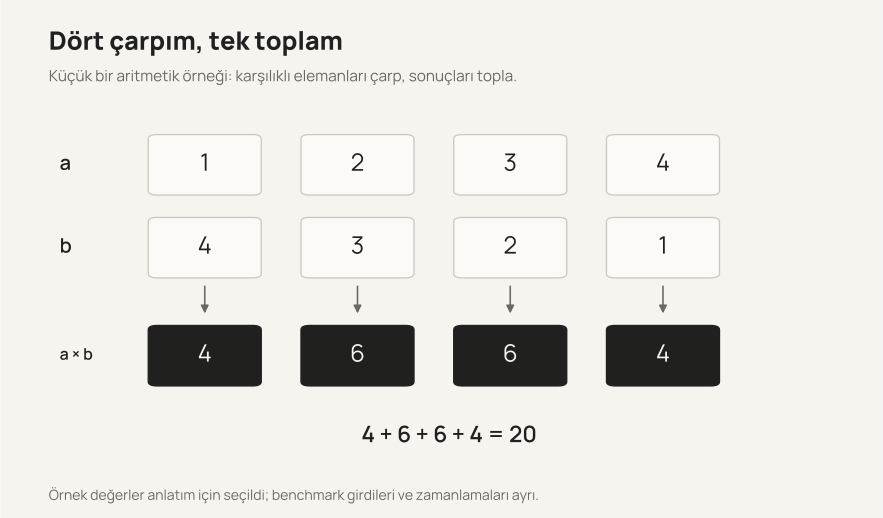
C++ tarafında bu, birkaç satırlık bir döngü:
float dot(const float* a, const float* b, std::size_t n) {
    float sum = 0.0f;
    for (std::size_t i = 0; i < n; ++i) {
        sum += a[i] * b[i];
    }
    return sum;
}
Dikkat edilmesi gereken yer sum. Her toplama, bir önceki toplamın sonucunu kullanıyor. İşlemcinin elinde aynı anda hesaplayabileceği çok sayıda çarpım olsa bile, bunları tek bir toplamın peşine dizdiğimizde bir bağımlılık zinciri kurmuş oluyoruz.
SIMD (single instruction, multiple data), tek komutla birden fazla veri elemanı üzerinde çalışmayı sağlıyor. Fakat bir vektör komutu kullanmak, bu toplama zincirinin de kendiliğinden bağımsız parçalara ayrıldığı anlamına gelmiyor.
Derleyicinin eli nerede bağlı?
Gerçek sayılarla toplarken parantezleri istediğimiz gibi değiştirebiliriz. float ile çalışırken ara sonuçlar yuvarlanıyor; parantezleri değiştirmek sonucun değişmesine yol açabiliyor.
Örneğin float32, 16.777.216 değerini (2^24) tam olarak tutabiliyor. Bundan sonraki daha büyük temsil edilebilir sayı 16.777.218. Aradaki 16.777.217, en yakına ve eşitlikte çift olana yuvarlama altında tekrar 16.777.216 oluyor.
Bu yüzden (2^24 + 1) - 2^24 hesabı 0 veriyor. Önce 1 - 2^24 işlemini yaparsak ara sonuç -16.777.215 oluyor ve tam temsil edilebiliyor. Buna 2^24 eklediğimizde sonuç 1.
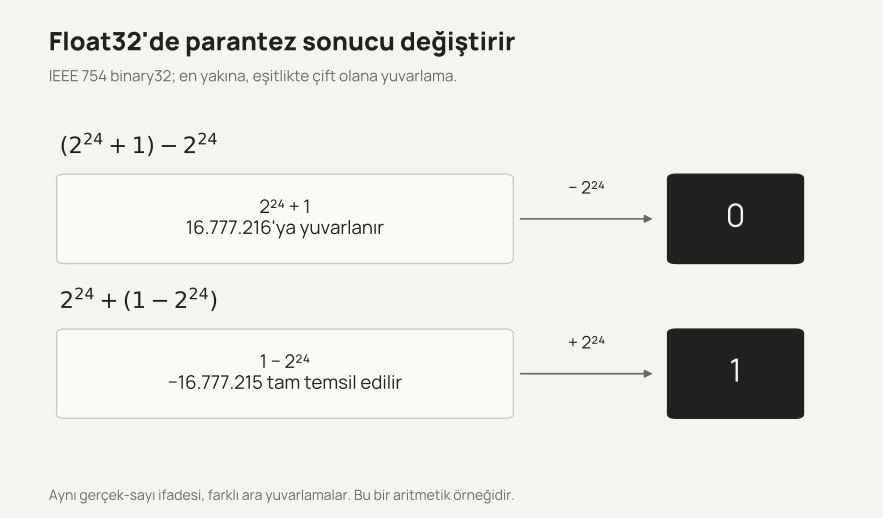
Derleyicinin sıralı toplamayı birkaç ayrı zincire bölmesi de böyle bir değişiklik yapabilir. Reassociation dediğim şey, işlemleri bu şekilde yeniden gruplamasına izin vermek.
LLVM belgeleri de kayan noktalı reduction’larda bu iznin önemini anlatıyor. Bazı hedeflerde işlem sırasını koruyan reduction desteği var; burada incelediğim x86 kaydında ise varsayılan toplama tek seri zincir olarak kalıyor. Sonucu bütün mimarilere yaymamak gerekiyor.
Dört sürümle neyi ayırıyorum?
Karşılaştırmada hesap aynı. Değişen, derleyicinin yapmasına izin verilen dönüşümler ve bir sürümde doğrudan yazılan AVX2 kodu.
| Sürüm | Nasıl derleniyor? |
|---|---|
| Scalar | Otomatik vektörleştirme kapalı referans döngü. |
| Compiler-optimized | Normal optimizasyonlar açık; toplamanın yeniden gruplandırılması ayrıca istenmiyor. |
| Compiler-reassociated | Aynı döngü, yeniden gruplamaya izin verilerek derleniyor. |
| Manual AVX2 | Sekiz float lane’i içeren vektörler ve dört bağımsız ara toplam kullanılıyor. |
Elle yazılmış sürümde her ana döngü adımı 32 elemanı işliyor: dört ayrı sekizli grup, dört ayrı accumulator. Accumulator, ara toplamı tutan değişken ya da register.
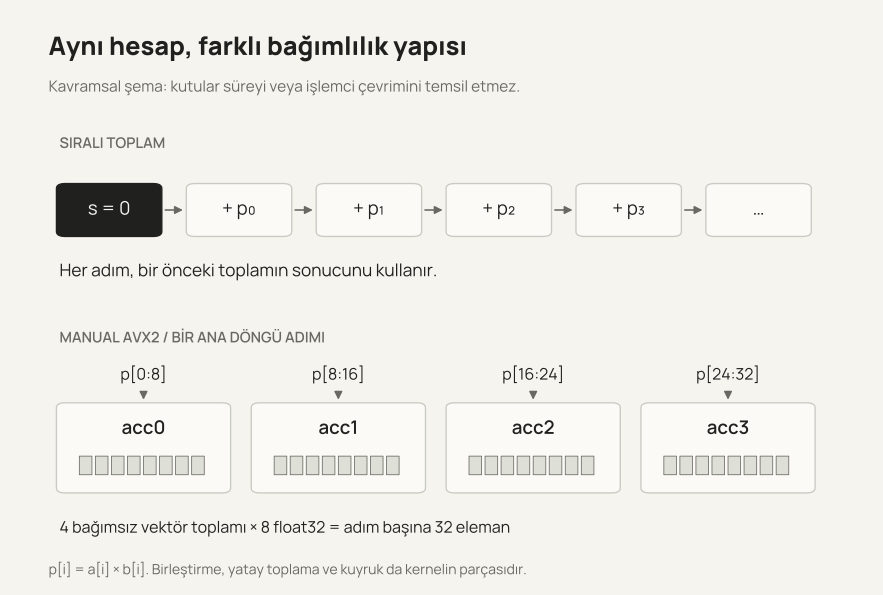
Bir accumulator kendi önceki sonucunu beklerken diğerleri ayrı zincirler üzerinde ilerleyebiliyor. Buradaki fikir komut düzeyinde paralellik: işlemciye birbirini beklemeyen işler bırakmak.
Ana döngüden sonra kalan tam sekizli bloklar işleniyor. Dört vektör toplamı birleştiriliyor, lane’ler tek toplama indiriliyor ve son 0-7 eleman scalar olarak ekleniyor. Bunların hepsi ölçülen kernelin içinde. Yalnızca hızlı ana döngüyü zamanlayıp kalan işi dışarıda bırakmıyorum.
Bu düzen toplama sırasını değiştiriyor. Dolayısıyla bit düzeyinde aynı sonucu korumak isteyen bir programda, sıralı döngünün yerine düşünmeden konabilecek bir sürüm değil.
Sonuçlarla biraz oynayalım
Aşağıdaki alanda eleman sayısını değiştirerek tek bir boyuta yakından bakabilirsin. Native / süre, GCC’nin dört sürümünü nanosaniye olarak karşılaştırıyor. AVX2 / oran ise GCC ve Clang’in yeniden gruplamalı sürümlerini elle yazılmış kernel ile karşılaştırıyor.
Aynı girdi, farklı derlemeler
GCC 15.2 · native · medyan ns/çağrı
4.096 eleman: yeniden gruplamalı derleyici 321 ns, elle AVX2 300 ns.
İlk satırdaki 17 katlık farkı, derleyicinin yeniden gruplamalı sürümüne karşı elde edilmiş gibi okumak kolay. Oysa n = 4096 için karşılaştırmalar ayrı:
- Scalar ile elle AVX2: 5.117 ns / 300 ns.
- Yeniden gruplamalı derleyici ile elle AVX2: 321 ns / 300 ns.
Birincisi büyük bir fark. İkincisinde ise derleyici oldukça yakında. Hangi sürümü başlangıç kabul ettiğimiz, çıkan hikâyeyi değiştiriyor.
GCC native kaydının bütün boyutlarına baktığımızda da aynı ayrım görünüyor:
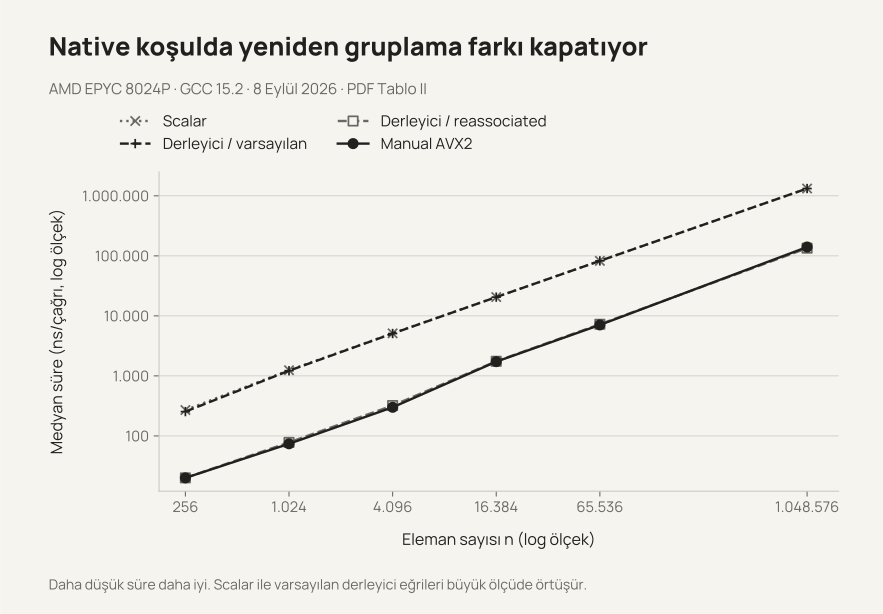
En büyük boyutta yeniden gruplamalı derleyici 134.203 ns, elle AVX2 ise 140.285 ns. Bu kez daha kısa süren derleyici çıktısı. Elle yazılmış kodun bütün boyutlarda önde olacağı gibi bir sonuç çıkmıyor.
Altı boyutun tamamını sayılarla gör
| Eleman sayısı | Scalar | Compiler-optimized | Compiler-reassociated | Manual AVX2 |
|---|---|---|---|---|
| 256 | 270 ns | 254 ns | 20 ns | 20 ns |
| 1.024 | 1.243 ns | 1.220 ns | 78 ns | 74 ns |
| 4.096 | 5.117 ns | 5.081 ns | 321 ns | 300 ns |
| 16.384 | 20.571 ns | 20.532 ns | 1.751 ns | 1.728 ns |
| 65.536 | 82.400 ns | 82.387 ns | 7.242 ns | 7.070 ns |
| 1.048.576 | 1.322.439 ns | 1.322.369 ns | 134.203 ns | 140.285 ns |
Birim, çağrı başına medyan nanosaniye. Nokta binlik ayırıcı. PDF’deki süreler yuvarlandığı için bu hücrelerden yeniden hesaplanan oranlar, raporlanan hızlanmalarla son basamakta aynı çıkmayabilir. Tablo II’nin CSV aktarımı da mevcut.
AVX2 ile sınırlayınca cevap değişiyor
Native derlemede aynı komut kümesiyle karşı karşıya değiliz: derleyici bu sunucuda AVX-512 kullanabilirken elle yazdığım kernel AVX2 olarak kalıyor. Bunun için ayrıca derleyici hedeflerini de -mavx2 ile sınırlayan bir kayıt aldım.
Bu koşulda Clang, elle yazılmış sürüme yakın kalıyor. GCC’de orta boyutlarda fark açılıyor; 4.096 elemanda yeniden gruplamalı derleyici sürümü, elle AVX2’nin 2,01 katı süre alıyor.
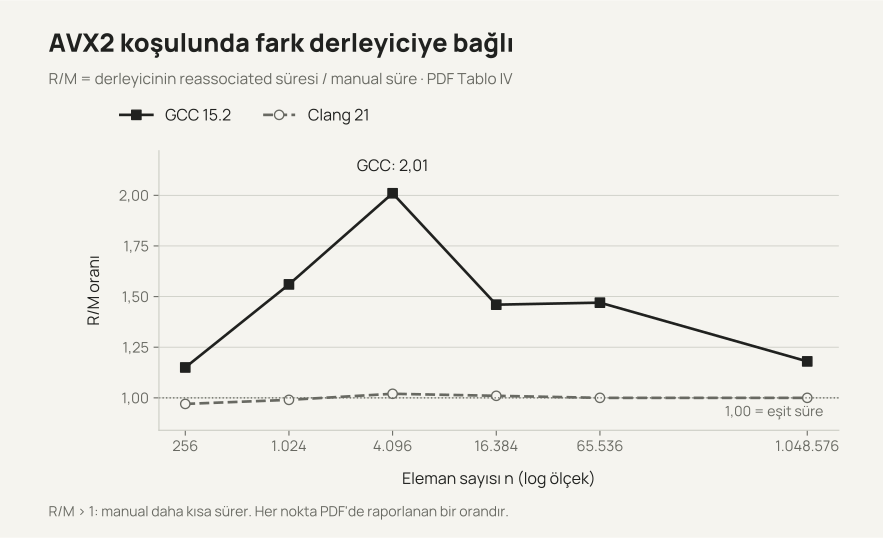
Native kayıtta R/M aralıkları GCC için 0,96-1,07, Clang için 0,89-1,05. AVX2 kaydında bunlar sırasıyla 1,15-2,01 ve 0,97-1,02 oluyor. Clang’in iki koşulda da yakın kalması, GCC’nin ise hedef değişince farklı davranması bu karşılaştırmanın önemli tarafı.
Assembly kayıtlarında buna uyabilecek bir fark var. AVX2 koşulunda GCC tek vektör accumulator kullanıyor; Clang ve elle yazılmış sürüm dört bağımsız accumulator taşıyor. Native’de 16 lane ile ilerleyen tek zincir, sekiz lane’li AVX2’ye geçince aynı girdiyi işlemek için daha fazla toplama adımı gerektiriyor.
Bu, kayıtları açıklamaya yardımcı oluyor. Yine de -march=native scheduling gibi başka tercihleri de etkiliyor. Ayrıca incelenen assembly/disassembly kayıtları aynı kaynak ve araç zincirinden üretilmiş destekleyici kayıtlar; doğrudan zamanlanan binary’nin disassembly’si değil. Sayaçlarla doğrulanmış bir neden-sonuç iddiasına kadar gitmiyorum.
AVX2 oranlarını tablo olarak gör
| Eleman sayısı | GCC R/M | Clang R/M |
|---|---|---|
| 256 | 1,15 | 0,97 |
| 1.024 | 1,56 | 0,99 |
| 4.096 | 2,01 | 1,02 |
| 16.384 | 1,46 | 1,01 |
| 65.536 | 1,47 | 1,00 |
| 1.048.576 | 1,18 | 1,00 |
Tablo IV’ün CSV aktarımı, scalar/manual oranlarını da içeriyor. Bu iki CSV, PDF tablolarının aktarımı; tek tek benchmark örneklerini içeren ham zamanlama kayıtları değil.
Bu sayılar nasıl alındı?
Ana sonuçlar 8 Eylül 2026 tarihli, AMD EPYC 8024P fiziksel sunucu kaydından geliyor. Boost kapalı, governor performance, iş tek çekirdeğe sabitlenmiş. GCC 15.2 ve Clang 21 kullanılıyor.
Girdi üretimi, bellek ayırma ve CSV yazımı zamanlamanın dışında. Aynı tamponlar tekrar kullanılıyor. Her boyutta iki koşudan yedişer örnek alınıyor ve bu 14 örneğin medyanı raporlanıyor. İki koşunun içindeki tekrarları, 14 bağımsız makine deneyi olarak saymıyorum.
Derleme bayrakları ve ölçüm düzeni
| Ayrıntı | Kullanılan düzen |
|---|---|
| Girdi | Pozitif ve negatif değerler içeren, periyotları 29 ve 17 olan deterministik sentetik diziler. |
| Boyutlar | 256, 1.024, 4.096, 16.384, 65.536 ve 1.048.576. |
| Isınma | Beş çağrı. Ardından en az 10 ms’lik bir zamanlama bloğuna ulaşana kadar artırılan tekrar sayısı; üst sınır 2^24. |
| Çağrı | Ortak function-pointer tablosu; bütün sürümler aynı çağrı yolundan geçiyor. |
| Derleme | Scalar ve derleyici sürümleri -O3; kernel çağrıları ayrı translation unit’lerde, LTO kapalı. |
| Scalar bayrakları | GCC: -fno-tree-vectorize; Clang: -fno-vectorize -fno-slp-vectorize. |
| Elle AVX2 bayrakları | -mavx2 -mno-fma -ffp-contract=off |
| FMA | Kayan noktalı contraction bütün sürümlerde kapalı; elle yazılmış sürüm FMA kullanmıyor. |
| GCC reassociation | -fassociative-math -fno-signed-zeros -fno-trapping-math |
| Clang reassociation | -ffast-math, ardından -ffp-contract=off |
Clang’in bayrakları yalnızca toplama sırasını gevşetmiyor. Sonradan eklenen -ffp-contract=off, fast-math içindeki diğer varsayımları geri almıyor. Bayrakların ayrıntıları GCC ve Clang belgelerinde var.
En büyük boyutta iki girdi dizisi toplam 8 MiB yer kaplıyor. Elle yazılmış kernel hizasız vektör yüklemeleri kullanıyor, x86-64 için derleniyor ve çalışırken AVX2 desteği kontrol ediliyor.
İlk fiziksel sunucunun 7 Eylül native kaydı ayrı bir tekrar olarak tutuluyor; ikinci sunucunun sonuçlarıyla havuzlanmıyor. Daha önceki VM kaydında CPU modeli ve kullanılabilen komut kümesi de farklı olduğu için, VM ile fiziksel sunucu arasındaki farkı yalnızca sanallaştırmaya bağlamak mümkün değil.
Doğruluk kontrolünde küçük bir tuzak
Toplama sırasını değiştirdiğimiz için bit düzeyinde eşitlik beklemiyorum. Her sürümün sonucu, aynı girdi üzerinde double referansla karşılaştırılıyor. İlk kabul eşiği şöyle:
abs(result - reference) < 1e-5 * max(1, sum(abs(a[i] * b[i])))
Burada mutlak ürünlerin toplamı kullanılıyor. Pozitif ve negatif terimler birbirini götürürse, bu toplam sonucun kendisinden çok büyük kalabiliyor.
En büyük boyutta eşik yaklaşık 2,25, referans sonuç yaklaşık -0,126. Yalnızca bu eşiğe bakılsaydı, sıfır döndüren hatalı bir uygulama bile geçebilirdi.
Bu nedenle kontrolü tek bir eşikte bırakmıyorum. Sonlu sonuç kontrolü, tam boyutlu tamponlar, n = 0..65 ve 0/1 ofsetlerinde ASan/UBSan kontrolleri de var. Ayrıca bütün ürünleri pozitif olan bir veri örneği, yüzde 0,01’lik göreli eşikle kontrol ediliyor; bu örnekte sıfır sonuç kabul edilmiyor.
Bu kontroller, kullanılan girdiler için anlamlı bir güvence sağlıyor. Farklı model girdileri ve modelin görev doğruluğu ayrıca değerlendirilmeli.
Kernelden modele geçmeden önce
Buraya kadar zamanladığım şey tek bir CPU dot product kerneli. Bir yoğun katmanda bunun gibi birçok iç toplam, bias ve başka işlemler var. Tam modelde bunlara diğer katmanlar ve veri kullanımı da ekleniyor.
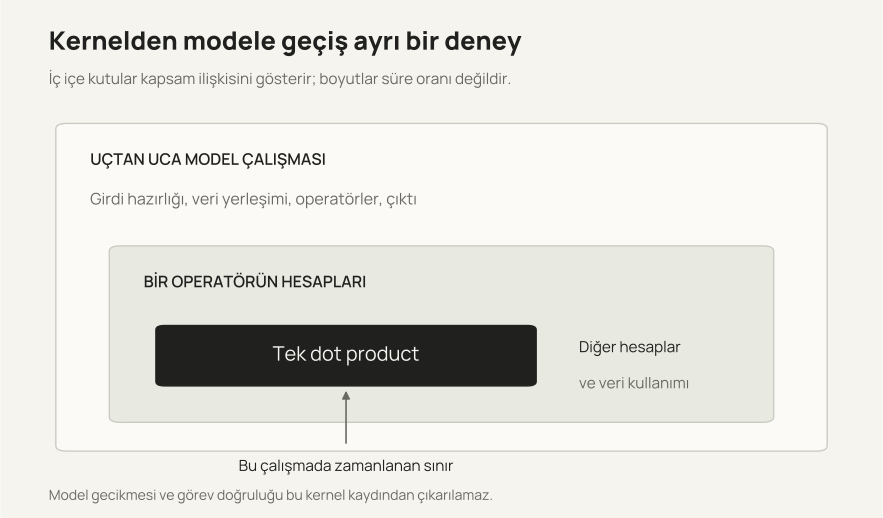
Dolayısıyla bu 17 katlık kernel karşılaştırmasından bir modelin 17 kat hızlanacağı sonucuna ulaşamam. Aynı şekilde, kerneldeki hata eşiğini geçmek de model doğruluğunu göstermiyor. Çalışmada uçtan uca model gecikmesi ve görev doğruluğu ölçülmedi.
Diğer sınırları da sonuçların yanında tutmak gerekiyor: girdiler sentetik, zamanlanan altı boyutun tamamı 32’nin katı ve sürümler sabit sırayla ölçülüyor. Kuyruk yolları doğruluk açısından kontrol edilmiş olsa da düzensiz boyutların performansı bu kayıtta yok. Cache ve bellek bant genişliği sayaçları da ölçülmedi; büyük girdide farkın azalmasını tek başına “memory-bound olduk” diye açıklayamam.
ARM kaydı yalnızca scalar ve varsayılan derleyici sürümlerini içeriyor. Onu, başka bir makinedeki x86 sonuçlarıyla genel bir mimari sıralamasına dönüştürmüyorum.
Benim için çıkan sonuç
Bu döngüde intrinsics yazmaya karar vermeden önce sayısal beklentiyi belirlemek ve derleyicinin ürettiği koda bakmak gerekiyor. Toplamanın yeniden gruplanması kabul edilebiliyorsa, Clang iki koşulda da elle yazılmış sürüme yakın. GCC’nin AVX2 kaydında ise elle yazılmış kodun karşılığı olan bir fark var.
Çalışmanın devamında bakılacak yer, aynı ayrımın küçük bir GEMV tabanlı katmanda ne kadar kaldığı. Tam operatörün süresi ve çıktısının hatası birlikte ölçülmeden, kernelde gördüğüm kazancı inference tarafına taşımış sayılmam.
Kaynak ve veri
Bu yazı, Omer Isildak — When Does Manual SIMD Beat Compiler Auto-Vectorization? A Kernel-Level Dot-Product Case Study for CPU Inference başlıklı çalışmamın Türkçe anlatımı. Çalışma gönderildi, değerlendirme sonucu bekleniyor.
Süreler ve oranlar PDF’nin Tablo II ve IV’ünden alındı. Şekil 4 ve 5 bu değerlerden çizildi; diğer dört şekil hesabı ve yöntemi açıklıyor. Yeni bir benchmark kaydı eklenmedi.
- Tablo II: GCC native süreleri, CSV
- Tablo IV: AVX2 oranları, CSV
- LLVM: reductions ve otomatik vektörleştirme
- GCC: optimizasyon seçenekleri
- Clang: kayan noktalı davranış
Small experiments. Honest notes.